Paletizar un pedido mixto es un problema NP-difícil. Con cien cajas de tamaños distintos hay más formas de acomodarlas de las que un computador puede revisar. Por eso se usan heurísticas, reglas que encuentran rápido una buena solución sin garantizar la mejor.
La investigación sobre armado de pallets suele resolver cada pedido por separado, sin mirar el camión ni la ruta. Los trabajos de ruteo con restricciones de carga sí consideran el camión completo y el orden de descarga, pero cargan cajas sueltas o pallets de un solo cliente. Pocos arman los pallets y los ubican en el camión a la vez1.
En la distribución hacen falta las dos cosas juntas. Lo que sale a ruta es un camión con los pedidos de varios clientes, repartidos en pallets que mezclan clientes y se cargan en orden inverso a las paradas. En cada parada, el ayudante saca las cajas de un cliente sin desarmar las del siguiente.
Necesitábamos un sistema que armara desde un pallet hasta la carga completa de un camión. Su núcleo es un solver, el programa que decide qué caja va dónde. En una flota de prueba de 80 camiones de unas 500 cajas cada uno, el solver armó cada camión en una mediana de 170 milisegundos. En 50 pedidos de prueba cuya mejor solución conocíamos, usó un pallet de más en 45.
Qué es paletizar un pedido mixto
Cada línea de un pedido es un SKU, un producto con su propio formato de caja. Varios SKU pueden compartir formato. Un pallet de un solo SKU se arma repitiendo la misma capa. Cuando el pedido mezcla productos, cada capa combina cajas de formatos distintos y hay que decidir dónde va cada una. La Figura 1 muestra tres pallets armados por nuestro sistema, de uno, tres y nueve SKU.
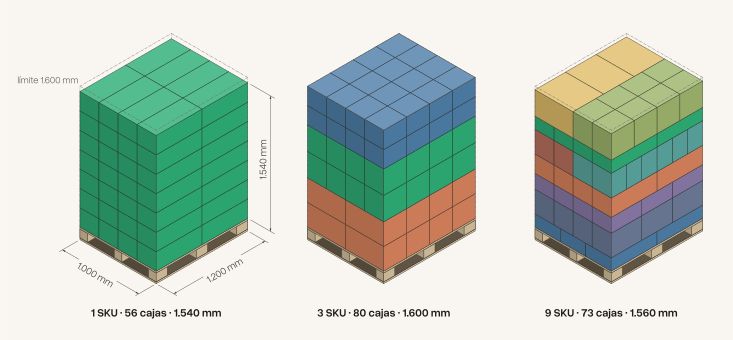
Figura 1. Cada color es un SKU y la línea punteada marca el límite de 1.600 mm. Para cada caso elegimos, entre unos 300 pedidos generados, uno con cajas cuyas medidas dividen la base del pallet. Son pedidos favorables, y la Figura 12 muestra uno típico.
Formalmente, un pedido es un conjunto de cajas, cada una con medidas y masa . Hay que repartirlo en pallets y dar a cada caja una posición que la deje dentro del volumen de su pallet, sin superponerse con otras, usando el menor posible. Usamos pallets de mm y mm.
Si todas las cajas tuvieran la base completa del pallet, solo importarían sus alturas. Habría que repartirlas en el menor número de pallets con en cada uno, que es el problema de empaque en contenedores en una dimensión, NP-difícil en sentido fuerte. El caso general contiene a ese caso particular, así que también es NP-difícil.
El modelo formal deja fuera cuatro condiciones que tiene que cumplir un pallet que se va a pickear.
- Grupos de picking. Las cajas de un mismo SKU para un mismo cliente van juntas, en un bloque que se pueda sacar en la parada.
- Física. Cada caja necesita apoyo, las pesadas van abajo y el pallet respeta su altura y su peso máximos. Las cajas pueden girar 90° sobre su eje vertical, pero nunca se voltean.
- Reglas de la operación. Cada empresa tiene las suyas, como temperatura separada, orden de ruta o clientes con pallets exclusivos. El solver las recibe como configuración.
- Tiempo. El plan se calcula con la ruta cerrada y los camiones esperando.
El apoyo de una caja es la fracción de su base que descansa sobre el tope de otras cajas,
donde es el área en que se superponen las bases de y vistas desde arriba y mm es la tolerancia de contacto. Una caja sobre el pallet tiene . Llamamos bien apoyada a una caja con , el umbral habitual en la literatura de ruteo con carga2, y contamos como flotando a una con , una categoría nuestra. La Figura 2 muestra los tres niveles.
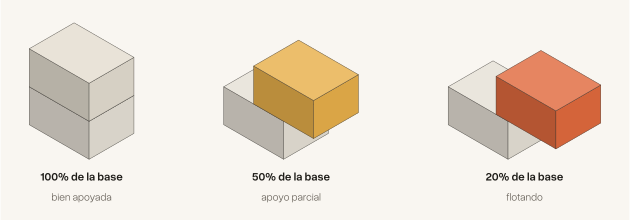
Figura 2. Una caja sobre otra con el 100%, el 50% y el 20% de su base apoyada, con los mismos colores de la Figura 12.
La unidad de trabajo es un camión
Un camión de la flota de prueba lleva unos 10 pallets de 1.000 × 1.200 mm y unas 500 cajas de diez clientes, una parada por cliente (Figura 3). El solver arma todos sus pallets a la vez, y después el sistema los ordena según la ruta.
Si es la parada de la caja , la primera entrega de un pallet es . Los pallets se cargan de mayor a menor , alternando entre las dos columnas. El pallet del fondo, contra la cabina, es entonces el que empieza a descargarse más tarde.
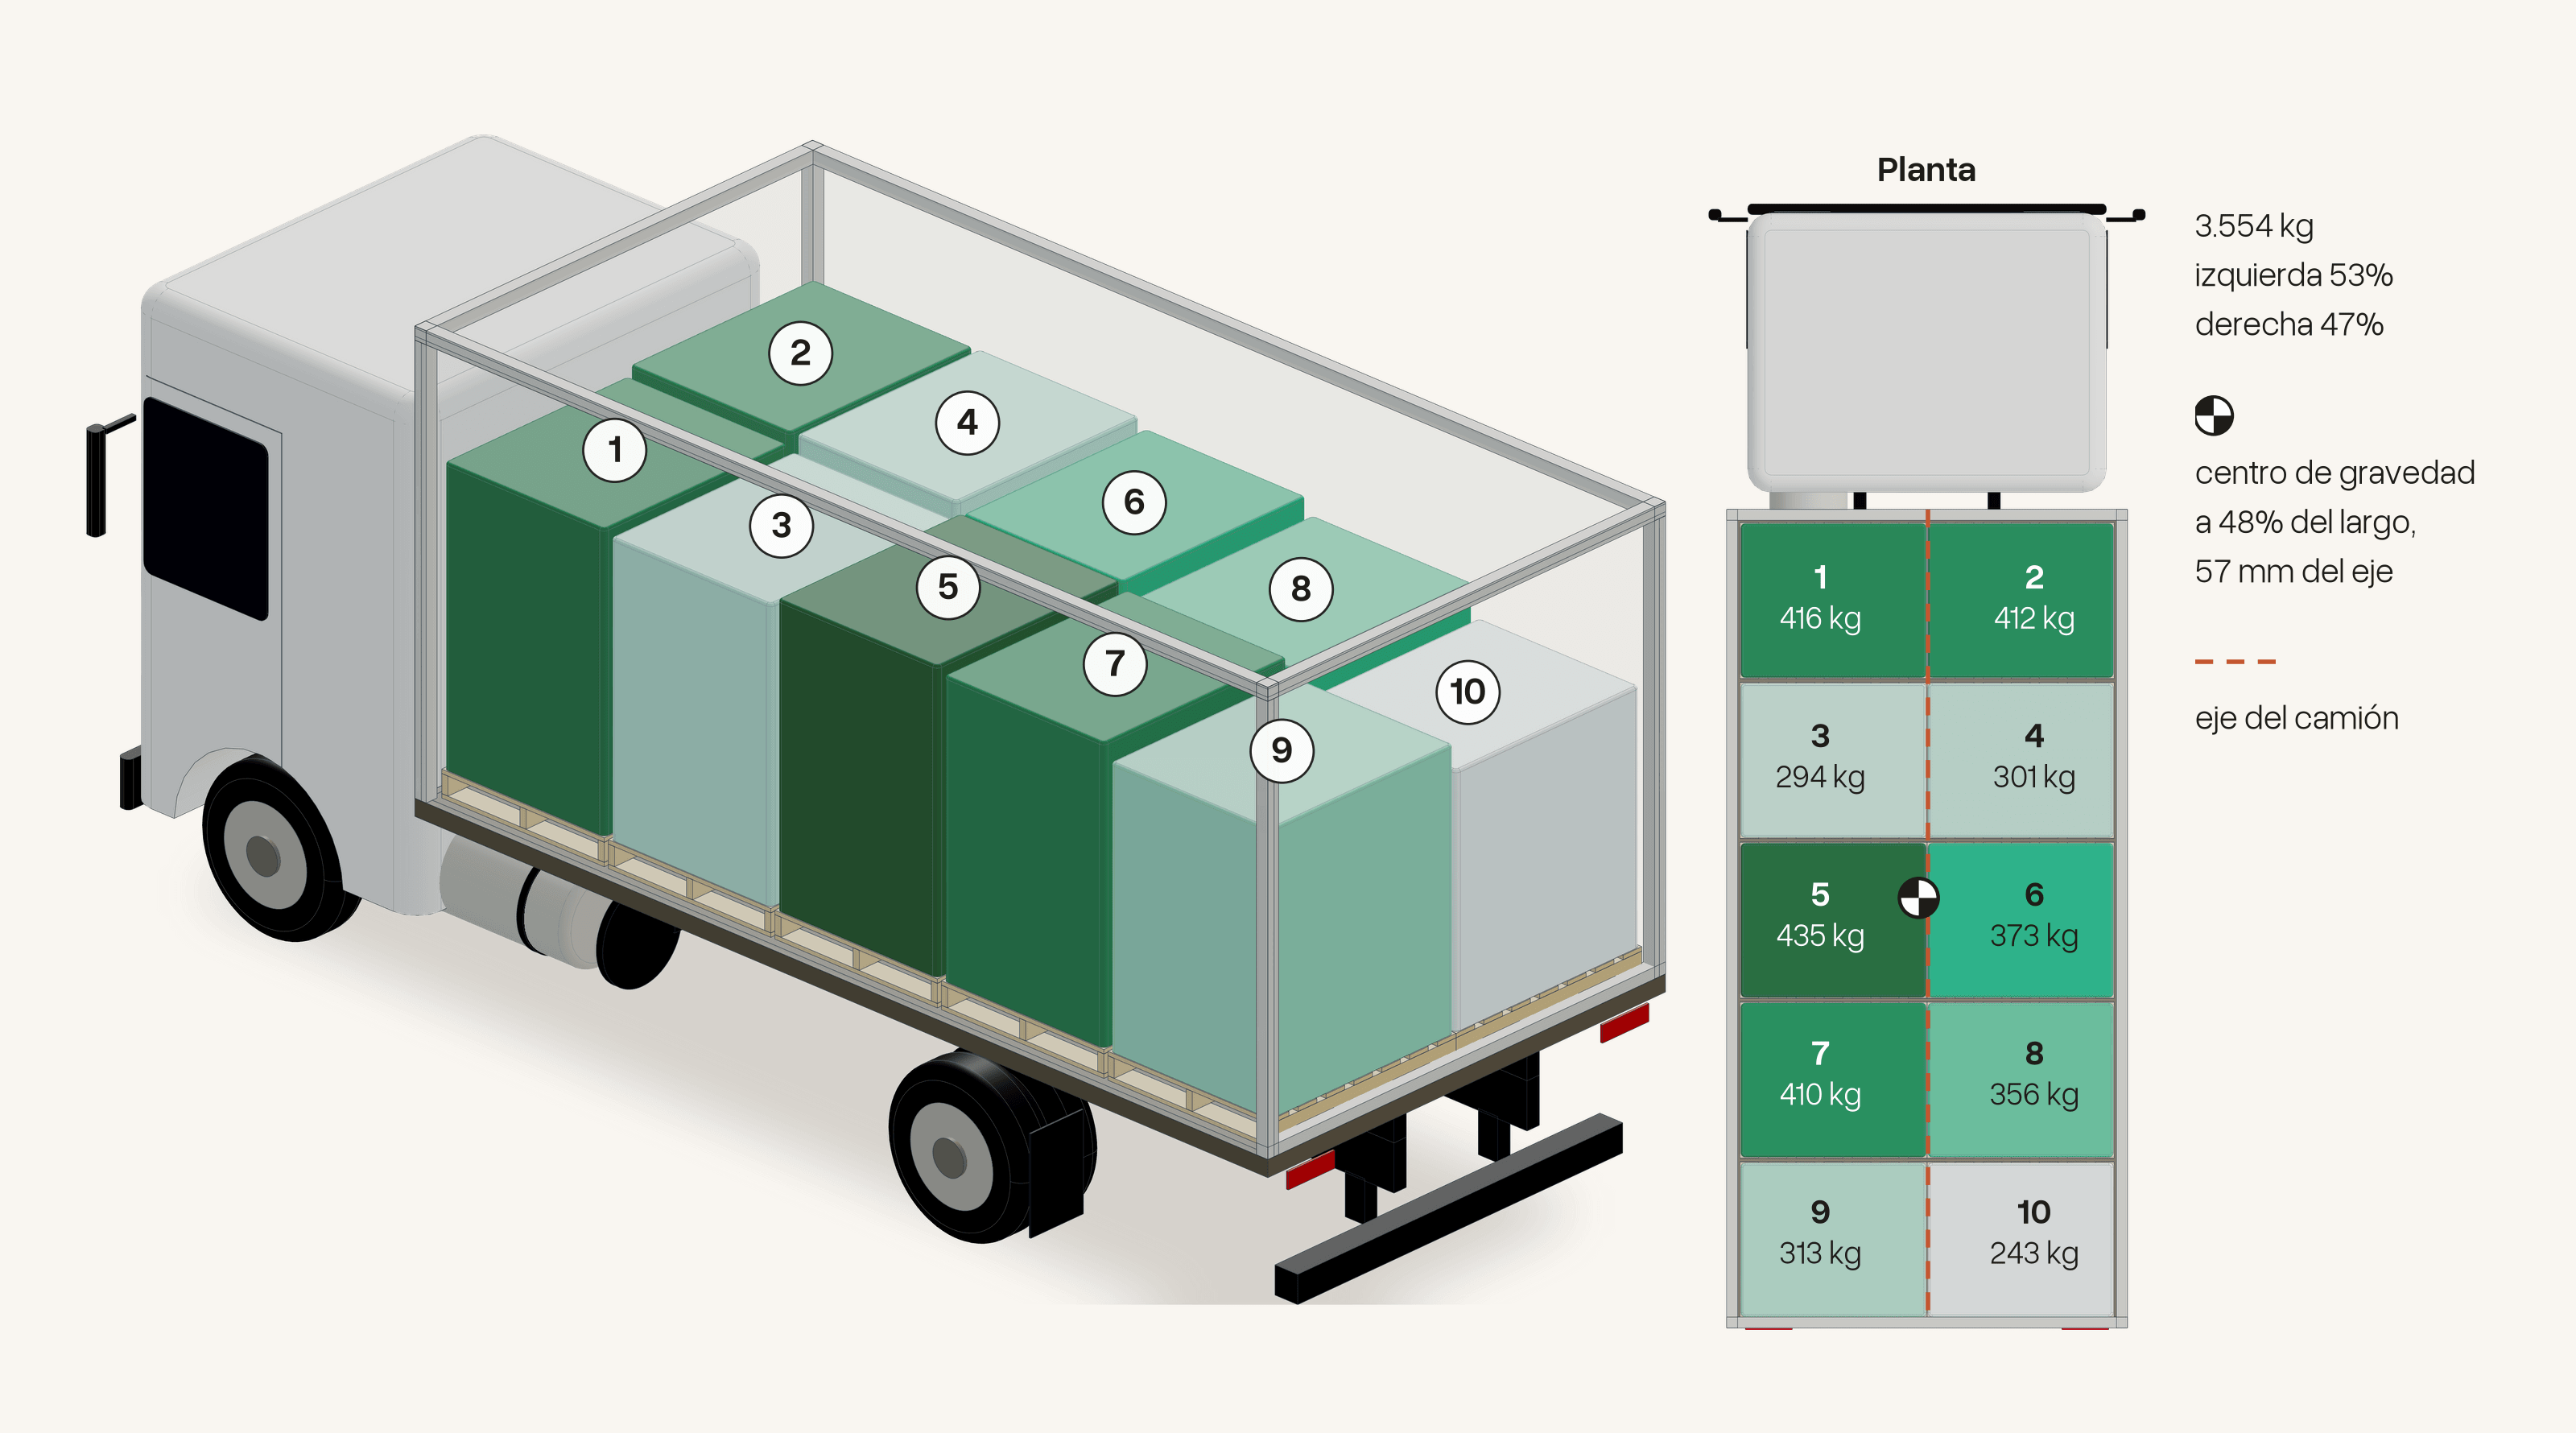
Figura 3. Un camión de la flota de prueba, modelado en CAD con sus 10 pallets en la posición y a la altura que entrega el solver. El número de cada pallet es su orden de carga, del 1, contra la cabina, al 10, junto a las puertas. El color marca el peso, de 243 a 435 kg, y la planta muestra el peso de cada pallet y el centro de gravedad de la carga. Elegimos el camión cuya diferencia de peso entre lados es la más cercana a la mediana de la flota (Figura 9).
Cómo armamos los pallets
Las reglas de la operación definen qué cajas pueden compartir un pallet. Dentro de esos límites, el solver decide cuántos pallets armar y qué va en cada uno.
Probar caja por caja sería demasiado lento. Lo comprobamos con un motor que ubica cada caja en los rincones libres de la superficie ya armada y aplica reglas de apoyo publicadas. No dejó cajas flotando, pero armó columnas de 2.969 mm en pallets con límite de 1.600 mm y tardó más de diez minutos en un conjunto de prueba, así que lo descartamos.
El solver trabaja con piezas más grandes. Junta las cajas idénticas de cada grupo de picking en bloques, arma capas con esos bloques y apila las capas en pallets (Figura 4). Construir con bloques y capas es una de las ideas más antiguas de la literatura sobre problemas de carga3. Con bloques, cada grupo de picking queda también en una sola pieza.
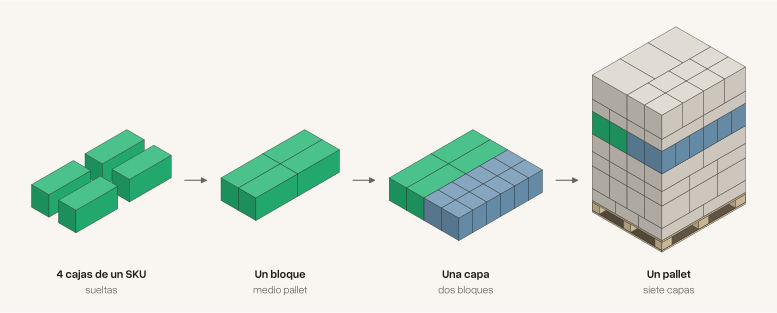
Figura 4. De la caja al pallet, en el pallet de nueve SKU de la Figura 1. Las cuatro cajas verdes forman un bloque de medio pallet. Ese bloque y uno de doce cajas azules forman una capa, y siete capas forman el pallet.
Cada capa sale de una búsqueda en haz. En cada paso, el solver extiende varias capas parciales con un bloque más, compara los resultados y conserva solo las mejores (Figura 5). Así no se compromete con una primera decisión que después deja huecos.
Si es el conjunto de capas parciales que conserva en el paso , el paso siguiente es
donde son los bloques que caben en lo que queda libre de la capa , es la capa con el bloque agregado y conserva las mejores según un puntaje de cobertura y contacto. Con sería un algoritmo voraz, y con sin límite, una búsqueda exhaustiva.
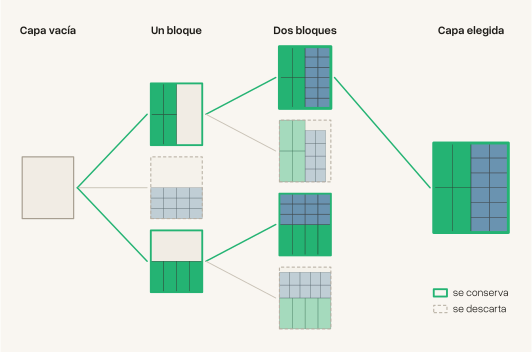
Figura 5. Esquema simplificado de una búsqueda en haz que conserva dos capas parciales por paso, con los bloques de la capa de la Figura 4. En el primer paso hay tres opciones para dos lugares y una queda fuera. En el segundo, cada opción conservada se extiende de dos formas, y las dos que dejan huecos se descartan.
Al apilar, una capa puede repetir las costuras de la capa de abajo. Si eso pasa varias capas seguidas, el pallet queda partido en columnas y su estabilidad depende solo del film. Por eso el solver rearma las capas mixtas para que crucen las costuras de la capa inferior, como se traba un muro de ladrillos4 (Figura 6). Las capas completas de un solo SKU no se rearman, y esos tramos quedan en columna.
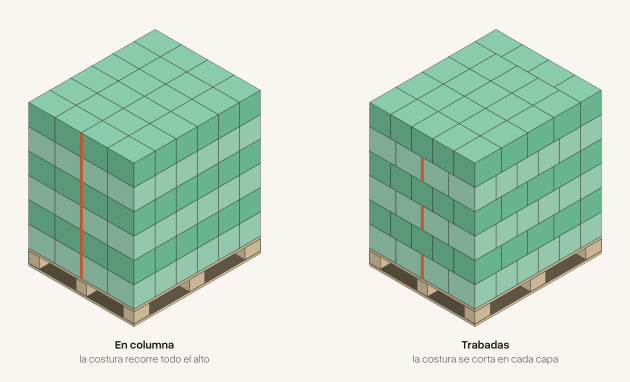
Figura 6. Esquema con 144 cajas idénticas apiladas de dos formas. En columna, todas las capas repiten el mismo patrón y la costura marcada recorre los 1.200 mm de carga. Trabadas, las capas alternan entre dos patrones y la misma costura se corta en cada capa.
Al final, el solver asienta cada caja donde la deja la gravedad y mide de nuevo qué parte de su base queda apoyada. Si un pedido no puede cumplir a la vez una regla y un límite físico, devuelve el mejor plan que encuentra y marca el pallet que excede el límite.
Cómo usamos IA para construirlo
Construimos el solver durante siete meses junto con agentes de programación. Nosotros definimos el problema, las reglas de cada operación y lo que cuenta como un buen pallet. Los agentes escribieron el código del solver, los experimentos y las herramientas para medirlos.
Lo que más cambió fue la velocidad para probar ideas. Cada idea pasa por el mismo ciclo (Figura 7). Un agente la implementa, corre el solver sobre baterías de pedidos de prueba y mide cada pallet caja por caja. Nosotros revisamos los resultados y decidimos si la idea se queda. Varias ideas pueden recorrer el ciclo en paralelo, y una variante del armado se puede diseñar, medir y descartar en un mismo día.
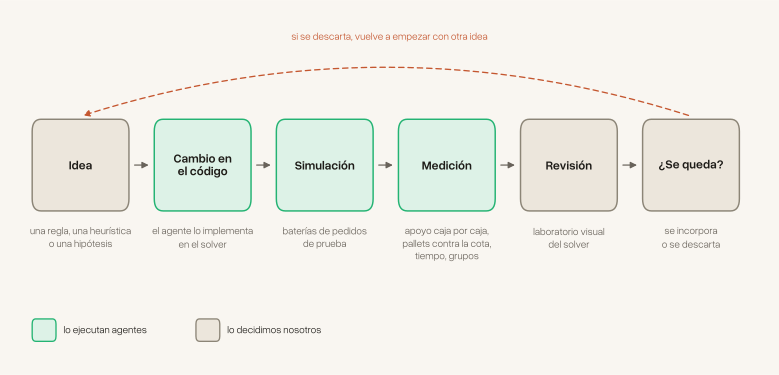
Figura 7. El ciclo con que probamos cada idea del solver. En verde, los pasos que ejecutan agentes, y en beige, los que decidimos nosotros.
Ese ritmo nos dejó probar teorías que a mano no habríamos alcanzado a probar. Más de una docena de ideas quedaron descartadas, cada una con su medición escrita. Varias mejoraban una medida y empeoraban otra, como el número de pallets o el tiempo de cálculo. Los agentes también construyeron simulaciones físicas del pallet y las interfaces con que revisamos el solver, como un laboratorio visual que repite paso a paso cómo se armó cada pallet. Con ellas, cada cambio se revisa mirando los pallets que produjo además de sus promedios.
Este trabajo tiene un límite claro. Cuando no se conoce la solución óptima, los agentes solo pueden mejorar las métricas que les damos, y una métrica puede verse bien en un pallet que no sirve. El motor de rincones libres no dejó ninguna caja flotando y aun así armó columnas que pasaban el límite de altura. Saber si un pallet es estable y se puede pickear sigue dependiendo de mirarlo, y ahí incluso los modelos más capaces que usamos no son confiables. Por eso la revisión visual y la decisión de cada cambio quedan en manos de personas.
En total consumimos unos 50.000 millones de tokens, el equivalente a unos US$20.000 a precio de lista.
Resultados en la flota de prueba
La flota de prueba tiene 80 camiones con pedidos de BED-BPP, un conjunto público de pedidos reales de supermercado5. Cada camión lleva diez clientes, y la flota suma 40.776 cajas. El solver la resolvió completa en 13,7 segundos, en un núcleo de un notebook Apple M4. Usó 798 pallets, sin cajas fuera ni pallets sobre el límite. El 81,7% de las cajas quedó bien apoyado y el 1,1%, flotando.
Cada camión tardó entre 100 y 290 milisegundos, con una mediana de 170 (Figura 8). Con 16 camiones en paralelo, y si el tiempo escalara sin pérdidas, la flota tomaría menos de un segundo. Estos tiempos no incluyen leer ni escribir en una base de datos.
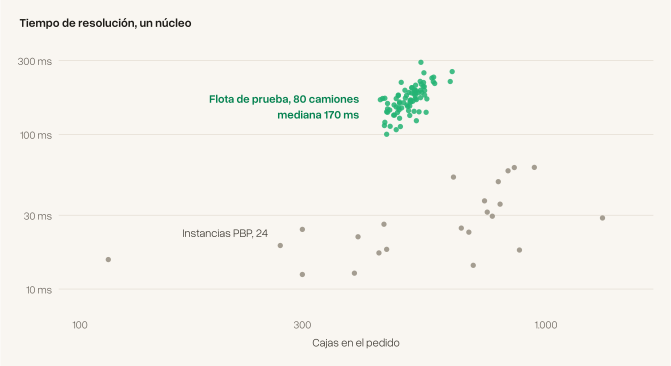
Figura 8. Tiempo de resolución contra cajas por pedido, en escala logarítmica. En verde, los 80 camiones de la flota de prueba (mediana de 3 corridas). En gris, las 24 instancias del benchmark público PBP, que comparamos más abajo (mediana de 5).
Dos trabajos que modelan restricciones prácticas reportan tiempos de otro orden. Uno, con instancias generadas a partir de datos de un operador logístico, reporta cerca de un minuto de cómputo por pallet, dentro del estándar de dos minutos por plan de su socio industrial. Otro arma capas con heurísticas y después las asigna a pallets con un modelo de programación entera. En sus tres pedidos más grandes, de 332 a 669 cajas, llegó al límite de 120 minutos en todas las corridas. A un minuto por pallet y en serie, los 798 pallets de nuestra flota tomarían más de 13 horas.
El orden de carga sale de la ruta y no considera el peso. Si y son las masas a la izquierda y a la derecha del eje del camión, la diferencia entre lados es . La mediana de en la flota es 5%. En el 10% de los camiones supera el 13%, y en el peor llega al 24%. El centro de gravedad a lo largo de la carga, , quedó siempre entre el 40% y el 56% del largo, medido desde la cabina (Figura 9).
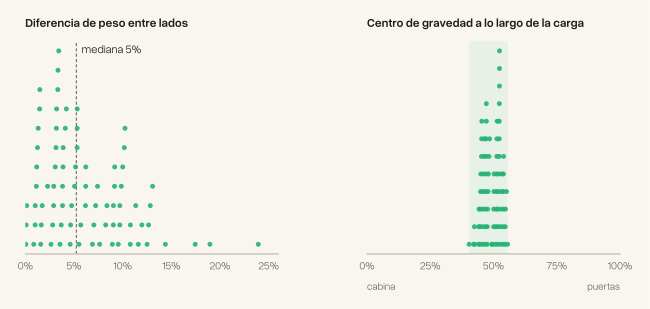
Figura 9. A la izquierda, la diferencia de peso entre lados en cada uno de los 80 camiones de la flota. A la derecha, la posición del centro de gravedad , desde la cabina hasta las puertas.
Para juzgar los 798 pallets los comparamos con una cota inferior. La de un camión es
el volumen de su carga dividido por el volumen útil de un pallet, redondeado hacia arriba. Ningún plan puede usar menos pallets. Sumada sobre los 80 camiones da 565. La diferencia con los 798 viene en parte del solver y en parte de la cota, que ignora la forma de las cajas, y no sabemos separar cuánto aporta cada una.
Qué tan lejos del óptimo
La cota inferior no dice cuánto de la diferencia es del solver. Para medirlo hace falta un pedido con respuesta conocida. Construimos 50 pedidos cortando pallets llenos en capas de cajas idénticas, con entre 1 y 16 pallets por pedido. El óptimo es el número de pallets cortados, y si el solver usa , la brecha relativa es .
El solver llegó al óptimo en 2 pedidos, usó un pallet de más en 45 y dos de más en 3. No dejó cajas fuera, y el 99% de las cajas quedó bien apoyado. Sus pallets quedaron llenos entre el 90% y el 95%. Lo que no cabe termina en un pallet extra, ocupado entre el 7% y el 73% (Figura 10).
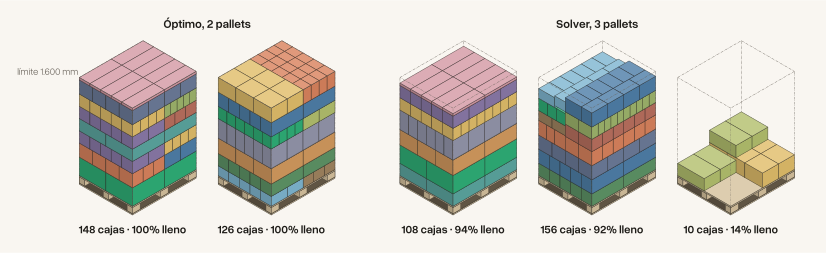
Figura 10. Un pedido de prueba cortado de dos pallets llenos, a la izquierda tal como se cortó y a la derecha como lo armó el solver. Cada color es un SKU. El solver dejó sus dos primeros pallets llenos al 94% y al 92%, y las 10 cajas que no cupieron fueron a un tercer pallet.
La tabla agrupa los 50 pedidos por tamaño, con diez pedidos en cada fila.
| Pallets en el óptimo () | Cajas por pedido | Pallets del solver (, promedio) | Pallets de más () | Brecha relativa |
|---|---|---|---|---|
| 1 | 119 | 1,9 | 0,9 | 90% |
| 2 | 255 | 2,9 | 0,9 | 45% |
| 4 | 462 | 5,0 | 1,0 | 25% |
| 8 | 968 | 9,0 | 1,0 | 13% |
| 16 | 1.895 | 17,3 | 1,3 | 8% |
Como la diferencia se mantiene cerca de un pallet, la brecha relativa cae aproximadamente como , de 90% en los pedidos de un pallet a 8% en los de 16.
Un benchmark público
Como referencia externa, corrimos el solver sin cambios en las 24 instancias del problema de armado de pallets (PBP) de Calzavara et al. (Annals of Operations Research, 2025). Vienen de un caso real de una empresa que fabrica sistemas robotizados de armado de pallets, y también exigen agrupar los ítems del mismo tipo. Nuestro solver usó 9,79 pallets en promedio, en 30 milisegundos por instancia. El algoritmo más rápido del paper usa 11,29 pallets en el mismo tiempo, y el que usa menos, 9,97 con 15 minutos de búsqueda (Figura 11).
La comparación es aproximada, y las diferencias de reglas van en las dos direcciones. Esos algoritmos deben armar capas horizontales completas y cumplir reglas de visibilidad que el nuestro no impone, y el nuestro exige un apoyo mínimo para cada caja. También corrieron en otro hardware6.
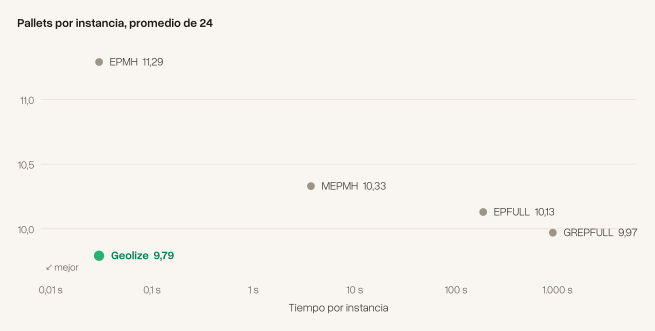
Figura 11. Pallets promedio contra tiempo por instancia, en escala logarítmica, en las 24 instancias de Calzavara et al. EPMH, MEPMH, EPFULL y GREPFULL son las variantes del paper, de la más rápida a la más exhaustiva. La cota inferior es de 7,6 pallets en promedio. Las reglas y el hardware difieren (ver texto).
Cuánto cuesta la variedad de cajas
En el pallet de un SKU de la Figura 1, cada caja apoya entera sobre la de abajo. Con muchos formatos, las capas pueden quedar a alturas distintas y con huecos (Figura 12). Un camión de la flota mezcla una mediana de 132 formatos de caja.
Con cargas tan heterogéneas, muchos métodos dejan de armar capas y ubican las cajas una por una7. Nosotros mantenemos las capas, así que medimos cuánto nos cuesta con cajas reales de supermercado y con los grupos de picking juntos.
Para aislar el efecto, armamos 1.320 pedidos sintéticos con cajas reales de BED-BPP. La carga de cada pedido equivale al 80% de 1, 2 o 4 pallets. Dentro de cada tamaño solo cambia cuántos formatos la componen, de 1 a 48, con 40 pedidos por combinación.
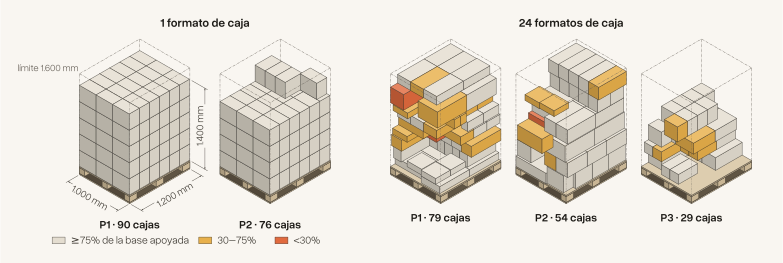
Figura 12. Dos pedidos con la misma carga, de unos dos pallets. El color marca qué parte de la base de cada caja queda apoyada, en gris si es el 75% o más, en ámbar entre 30% y 75% y en rojo bajo el 30%. De cada grupo de 40 elegimos el pedido más típico. Con un formato, 166 cajas caben en 2 pallets y todas quedan bien apoyadas. Con 24 formatos, 162 cajas usan 3 pallets y el 77% queda bien apoyado.
El apoyo cae a medida que crece la variedad (Figura 13). En pedidos de dos pallets, las cajas bien apoyadas bajan de 100% con un formato a 77% con 24 (intervalo del 95%, 75–78%)8. Con 48 formatos llegan a 71%. Las cajas flotando pasan de 0% con un formato a 3,9% con 24. Los pedidos chicos pierden más, y con 48 formatos un pedido de un pallet deja bien apoyadas solo el 58% de sus cajas.
La variedad también cuesta pallets. Con un formato, los pedidos de dos pallets usaron 2,1 pallets en promedio, y con 24 formatos usaron 3,0, uno más que la cota inferior en cada pedido. La densidad mide qué parte del volumen de los pallets, hasta su altura real, ocupan las cajas. Si es el volumen de las cajas y la altura del pallet , es . Bajó de 88% con un formato a 70% con 24.
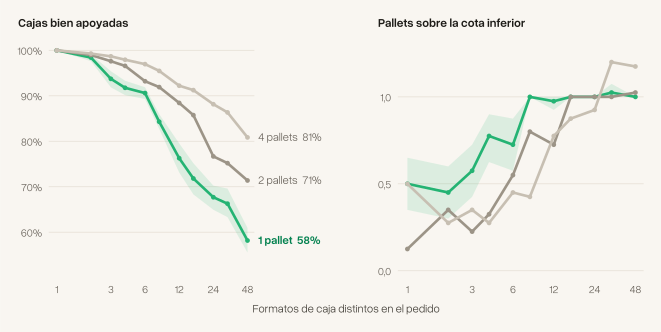
Figura 13. Cada punto promedia 40 pedidos con la misma carga, y la banda verde es el intervalo de confianza del 95%. A la izquierda, la proporción de cajas bien apoyadas. A la derecha, los pallets que usa cada pedido por sobre la cota inferior. Los pedidos de un pallet, en verde, son los que más pierden.
Algunos formatos aparecen una vez y otros decenas de veces, así que para comparar la flota con el experimento medimos la variedad con la entropía de la mezcla. Si es la proporción de cajas del formato , la entropía y el número efectivo de formatos son
es el número de formatos igual de frecuentes que darían la misma entropía. En los pedidos sintéticos las cantidades son casi parejas, así que 24 formatos equivalen a unos 21.
Los 132 formatos de un camión típico de la flota equivalen a 89, más que cualquier pedido del experimento. Aun así, la flota dejó bien apoyado el 81,7% de las cajas, casi lo mismo que los pedidos sintéticos de cuatro pallets con 48 formatos, que llegaron a 81%. Los pedidos grandes pierden menos apoyo, y un camión de la flota lleva unos 10 pallets.
Creemos que la causa es la que sugiere la Figura 12. Un formato que aparece pocas veces no alcanza para formar una capa, sus cajas terminan en bloques mixtos y esos bloques dejan alturas desparejas. No medimos esta explicación por separado, y no sabemos si otro método perdería apoyo al mismo ritmo.
Las reglas de cada operación
Las reglas de una operación cuestan pallets, y cuestan más cuando el camión mezcla más formatos. Lo medimos en 120 camiones sintéticos de seis clientes, con entre 6 y 48 formatos, y resolvimos cada uno con distintas combinaciones de reglas.
La medida es , los pallets usados por cada pallet de volumen de carga. Si todos los pallets llegaran a la altura máxima, sería el inverso de . Con solo la regla de los grupos de picking, sube de 1,36 con 6 formatos a 1,79 con 48. Con todas las reglas de la operación, entre ellas temperatura separada y orden de ruta, sube de 1,69 a 2,47 (Figura 14).
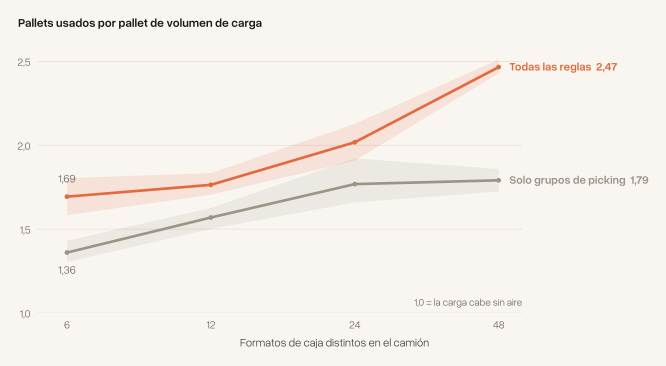
Figura 14. Pallets usados por cada pallet de volumen de carga, en camiones sintéticos de seis clientes, 30 por punto. La banda es el intervalo de confianza del 95%.
Una regla puede chocar con un límite físico. Con una regla que junta las cajas de cada cliente, 88 de 320 pallets quedaron sobre la altura máxima, porque algunos clientes no cabían en un pallet. El solver mantuvo la regla, marcó esos pallets y deja que la operación decida qué cede.
Armar el pallet en la bodega
Picking es armar el pallet en la bodega. Un operario recorre las ubicaciones con un pallet vacío, saca las cajas de cada pedido y las apila capa por capa. El plan del solver dice dónde va cada caja y en qué capa. Armando de abajo hacia arriba, cada caja cae sobre otra que ya está puesta.
El simulador arma así un pallet que el solver planificó para un pedido de prueba con tres clientes y siete SKU. Las cajas de cada cliente quedan en capas seguidas, y el cliente que se entrega último va abajo. El operario toma las cajas de un SKU, las pone y pasa al siguiente, y la lista de picking muestra esos pasos cliente por cliente. Se puede reproducir, avanzar caja por caja, saltar a un SKU o girar el pallet.
Cargando simulador…
Pallet vacío
Lista de picking
Arrastra el pallet para girarlo. Toca un SKU para saltar a ese paso.
Simulador. Un pallet del solver, de 69 cajas en siete capas completas, armado desde la tarima en un orden en que podría apilarlo un operario. Cada cliente tiene una familia de color y cada tono es un SKU. Mientras se pickea un SKU, el resto del pallet se atenúa, y la lista de picking marca un paso por SKU y capa.
Un pallet se puede pickear si cada grupo de picking sale en una sola pieza. Lo medimos con la misma regla de conexión que aplica el solver, así que es una prueba de consistencia. Dos cajas del grupo están unidas si se tocan, o si las separa un espacio corto sin cajas de otro grupo en medio9.
En la flota, más de la mitad de los grupos son de una sola caja. De los 10.148 grupos con dos o más cajas en un pallet, el 98,0% formó un solo bloque. Del total de grupos, el 1,1% quedó repartido entre pallets. Los grupos grandes se parten más. En los camiones sintéticos, donde los grupos tienen decenas de cajas, entre el 79% y el 84% de ellos formó un solo bloque. La Figura 15 muestra un pallet con dos grupos partidos.
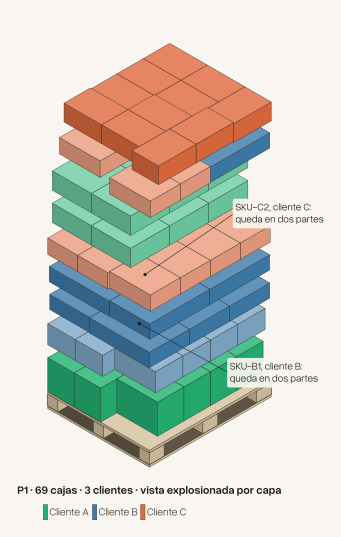
Figura 15. Un pallet de un pedido de prueba con tres clientes, separado por capas para ver su interior. Cada cliente tiene una familia de color y cada tono es un SKU. Dos de sus seis grupos de picking quedaron en dos partes, como marcan los rótulos. El segundo pallet del pedido tiene sus seis grupos en un solo bloque.
Lo que pasa en cada parada
En ruta, el ayudante del camión saca en cada parada las cajas de ese cliente. Los pallets se cargan en el orden inverso de la ruta, así que los de las primeras paradas quedan junto a las puertas (Figura 3). El plan dice además en qué pallet y en qué capa va cada caja, de modo que en cada parada se sabe de antemano qué pallets abrir.
Cada SKU sale en una sola pieza. Un cliente de la flota recibe una mediana de 52 cajas de 26 SKU, y el ayudante las saca en una mediana de 27 bloques, casi uno por SKU. Es el efecto de mantener juntos los grupos de picking al armar.
Como los pedidos son chicos, el solver mezcla clientes para llenar capas, y las cajas de un cliente quedan en una mediana de 7 pallets. Mezclar es una decisión de costo, porque las reglas que agrupan cajas por ruta o por cliente cuestan pallets. Con todas las reglas de la operación, sube de 1,36 a 1,69 con 6 formatos (Figura 14). Cada operación elige qué le conviene, y el solver arma con cualquiera de las dos configuraciones.
Lo que estos resultados no muestran
- La física está modelada por área de apoyo, no medida. No verificamos el equilibrio de cada caja ni el efecto del film.
- Las capas completas de un solo SKU se apilan en columnas. En esos tramos una costura recta puede recorrer todo el pallet, y la estabilidad depende del film.
- No calculamos cargas por eje. Reportamos el centro de gravedad al salir, pero la prueba legal depende de cada camión y el reparto cambia en cada parada. En un estudio de ruteo, ignorar los ejes dejó más del 25% de los tramos sobre algún límite10.
- No volvemos a medir el apoyo después de cada parada. Sacar los grupos de un cliente puede dejar sin apoyo a las cajas que quedan.
- El orden de las paradas dentro de un pallet no está garantizado. Los pallets se cargan según la ruta, pero dentro de un pallet el primer cliente no siempre queda arriba.
- No medimos el tiempo en ruta. Mezclar clientes llena las capas con menos pallets, pero el ayudante abre más pallets en cada parada. No medimos cuánto tiempo agrega eso.
Lo que sigue
El armado de pallets no tiene una solución fija. El mejor pallet depende de la operación que lo usa, de sus cajas, sus reglas y lo que pasa con el pallet después de armarlo. Por eso trabajamos en el solver todos los días, y cada cambio se mide contra pedidos de prueba antes de entrar. A veces eso significa ajustarlo a los requisitos de una operación. La mayor parte del tiempo apuntamos a lo mismo, pallets que se arman rápido y que sirven para el picking.
Nuestro foco son los pallets que se arman para pickear y salir en ruta el mismo día. Ahí importan la velocidad, que cada grupo de picking quede en un bloque y que cada caja quede bien apoyada. Un pallet que va a pasar meses apilado en una bodega es otro problema, y la literatura considera condiciones que en nuestro caso pesan menos11.
- Resistencia de cada caja. Los modelos con resistencia limitan el peso que soporta cada caja antes de aplastarse12. La resistencia de una caja de cartón depende del material, de la humedad y del tiempo que pasa bajo carga13, así que es decisiva en pallets almacenados. En un pallet que viaja horas pesa menos, y el solver la aproxima poniendo las cajas pesadas abajo. La estamos estudiando para operaciones que tengan ese dato por SKU.
- Estabilidad en movimiento. Medir cómo se comporta una carga en frenadas y curvas requiere simular el transporte14. Nosotros medimos el apoyo estático de cada caja, y la sujeción en ruta queda a cargo del film.
- Modelos exactos. Los modelos de programación entera que incluyen apoyo y resistencia resuelven solo problemas de tamaño moderado15. Con la ruta cerrada y el camión esperando, preferimos una heurística que responde en milisegundos, y medimos cuánto se aleja de la cota.
Lo que más nos ocupa hoy son los pedidos chicos con muchos formatos, el caso que la literatura reconoce como el más difícil de armar por capas. Para ese caso estamos trabajando en bloques compactos con pocas cajas de cada formato, que llenen los espacios entre capas. También queremos que la ruta pese al armar, para juntar las cajas de cada cliente en menos pallets sin perder capas completas. Si tu operación arma pallets mixtos que después se pickean, escríbenos.
Notas
- Sobre armado de pallets, ver Gzara, Elhedhli y Yildiz (2020) y Calzavara et al. (2025). Sobre ruteo con restricciones de carga, Iori y Martello (2010) y la revisión de Pollaris et al. (2015). Alonso et al. (2016) arman los pallets y los cargan en el camión a la vez, en transporte entre bodegas, sin paradas múltiples ni grupos de picking. No conocemos trabajos que armen pallets compartidos por varios clientes de una misma ruta, aunque nuestra búsqueda no fue exhaustiva. El problema es NP-difícil porque generaliza el empaque en contenedores (Dell'Amico y Magnani, 2021).
- Miao et al. (2012) describen el 75% de apoyo como el requisito estándar del ruteo con carga tridimensional, y Gzara, Elhedhli y Yildiz (2020) usan 70%. El apoyo de cada caja no garantiza que la pila completa sea estable, porque eso depende del centro de gravedad del conjunto (Krebs, Ehmke y Koch, 2021).
- Las capas y paredes vienen de George y Robinson (1980). La búsqueda en haz para armar capas sigue a Araya y Riff (2014), Araya, Moyano y Sánchez (2020) y Fanslau y Bortfeldt (2010).
- Carpenter y Dowsland (1985) formalizaron el criterio de trabar capas para que las costuras no se repitan.
- Kagerer et al., BED-BPP, un benchmark de empaque robótico con 10.003 pedidos reales de supermercado. Usamos sus 1.730 formatos de caja distintos, con su peso y la frecuencia con que aparece cada uno.
- Los algoritmos publicados corrieron en una máquina virtual con un Xeon de 2,0 GHz, y el nuestro, en un núcleo de Apple M4. Además de capas horizontales, esas instancias exigen una capa residual en el tope, factores de llenado mínimos y que cada ítem sea visible desde un costado. La cota inferior que calculamos (7,62 pallets en promedio) coincide con la que reporta el paper (7,63).
- Zhao et al. (2016) observan que con cargas muy heterogéneas los métodos suelen ubicar las cajas una por una en vez de armar capas. Las instancias BR1 a BR15 de Bischoff y Ratcliff (1995) y Davies y Bischoff (1999), con entre 3 y 100 formatos de caja, se diseñaron para medir ese caso.
- Los intervalos del 95% son intervalos bootstrap de percentiles, con 2.000 remuestreos de los 40 pedidos de cada punto.
- Dos cajas de un grupo están unidas si se tocan o están a 30 mm o menos, o si están a 250 mm o menos y ninguna caja de otro grupo ocupa el espacio entre ellas. Un grupo forma un solo bloque si todas sus cajas en un pallet quedan conectadas por esa relación.
- Pollaris et al. (2017) cargan pallets según la ruta y revisan los límites por eje en cada tramo. Ramos, Silva y Oliveira (2018) muestran que un centro de gravedad cerca del centro no basta, porque el límite real depende de la distancia entre ejes y del peso del camión vacío.
- Bortfeldt y Wäscher (2013) revisan las restricciones prácticas de la carga de contenedores, entre ellas el peso máximo y su distribución, la orientación de las cajas, su resistencia y la estabilidad de la carga.
- Bischoff (2006) arma cargas en las que el peso sobre cada caja no puede superar lo que soporta antes de dañarse.
- La fórmula de McKee, Gander y Wachuta (1963) estima la resistencia a la compresión de una caja a partir del cartón y su perímetro. Frank (2014) revisa los factores que la cambian en uso, como la humedad y el tiempo bajo carga.
- Ramos et al. (2015) evalúan la estabilidad de cargas con un simulador físico del transporte y proponen métricas como el número de cajas que caen.
- Junqueira, Morabito y Yamashita (2012) formulan modelos de programación entera con estabilidad y resistencia de la carga, y reportan que resuelven solo instancias de tamaño moderado.